
Dr. Aldo H. Romero
West Virginia University, USA.
Talk Abstract / Resumen
English
When a phone map application draws a blue line across a continent or a city in a fraction of a second, it hides one of the deepest and most useful ideas in computer science. A road network has millions of intersections, and the number of possible routes between two distant points is astronomically large, yet the answer arrives instantly and is probably optimal. This talk traces how that became possible—and argues that the same idea quietly powers much of modern science, including my own field of materials discovery.
We begin with the elegant core: Edsger Dijkstra’s 1959 shortest-path algorithm, reportedly designed in twenty minutes at a café. We then show that modern navigation does not replace Dijkstra’s idea but engineers increasingly clever structures around it—heuristic (A*) search, bidirectional search, automatically inferred road hierarchy, and preprocessing techniques such as contraction hierarchies and hub labeling that answer continental queries in microseconds while separating what changes slowly (the map) from what changes quickly (the traffic).
The heart of the talk is that “shortest path” is not really about maps at all. It is a universal way to reason about cost in a network, and it appears throughout the physical sciences: the minimum-energy path over a reaction barrier, the lowest-barrier percolating channel for lithium ions in a battery electrode, the optimal route between two minima on an energy landscape, the dominant pathway in a kinetic transition network, the bottleneck pore in a zeolite, and the least-resistance path a crack follows through a solid. In several of these, Dijkstra’s algorithm appears by name inside the tools materials scientists already use. We close by asking what materials discovery could gain by importing not just the algorithm, but the decades of engineering built around it: an energy landscape explored millions of times during high-throughput screening is, algorithmically, a road network queried millions of times—and the same speed-ups apply.
Español
Cuando una aplicación de mapas en el teléfono dibuja una línea azul a través de un continente o una ciudad en una fracción de segundo, oculta una de las ideas más profundas y útiles de la informática. Una red de carreteras tiene millones de intersecciones, y el número de rutas posibles entre dos puntos distantes es astronómicamente grande, sin embargo, la respuesta llega al instante y probablemente sea óptima. Esta charla rastrea cómo esto fue posible, y argumenta que la misma idea impulsa silenciosamente gran parte de la ciencia moderna, incluido mi propio campo de descubrimiento de materiales.
Comenzamos con el núcleo elegante: el algoritmo de ruta más corta de Edsger Dijkstra de 1959, supuestamente diseñado en veinte minutos en un café. Luego mostramos que la navegación moderna no reemplaza la idea de Dijkstra, sino que diseña estructuras cada vez más inteligentes a su alrededor: búsqueda heurística (A*), búsqueda bidireccional, jerarquía de carreteras inferida automáticamente y técnicas de preprocesamiento como jerarquías de contracción y etiquetado que responden consultas continentales en microsegundos mientras separan lo que cambia lentamente (el mapa) de lo que cambia rápidamente (el tráfico).
El corazón de la charla es que la "ruta más corta" en realidad no se trata de mapas en absoluto. Es una forma universal de razonar sobre el costo en una red, y aparece en todas las ciencias físicas: la ruta de mínima energía sobre una barrera de reacción, el canal de percolación de barrera más baja para iones de litio en un electrodo de batería, la ruta óptima entre dos mínimos en un paisaje de energía, la vía dominante en una red de transición cinética, el poro de cuello de botella en una zeolita y la ruta de menor resistencia que sigue una grieta a través de un sólido. En varios de estos, el algoritmo de Dijkstra aparece por su nombre dentro de las herramientas que los científicos de materiales ya usan. Cerramos preguntando qué podría ganar el descubrimiento de materiales al importar no solo el algoritmo, sino las décadas de ingeniería construidas a su alrededor: un paisaje de energía explorado millones de veces durante el cribado de alto rendimiento es, algorítmicamente, una red de carreteras consultada millones de veces, y se aplican las mismas aceleraciones.
Biography / Reseña Curricular
English
Aldo Romero is the Eberly Family Distinguished Professor of Physics and Director of Research Computing at West Virginia University. His work spans computational materials science, high-performance computing, artificial intelligence, and quantum computing, with over 300 scientific publications and extensive experience in developing computational methods and scientific software.
His work in artificial intelligence further extends to interdisciplinary projects in biology—including the DOE Genesis initiative—forensic sciences, computer science, mathematics, neuroscience, and AI applications in quantum computing. He is a Fellow of the American Physical Society and has led major research, computational infrastructure, and artificial intelligence initiatives bridging fundamental science, advanced computing, and data-driven discovery.
Español
Aldo Romero es Profesor Distinguido Eberly Family de Física y Director de Computación para la Investigación en West Virginia University. Su trabajo abarca la ciencia computacional de materiales, la computación de alto rendimiento, la inteligencia artificial y la computación cuántica, con más de 300 publicaciones científicas y una amplia experiencia en el desarrollo de métodos computacionales y software científico.
Su trabajo en inteligencia artificial se extiende además a proyectos interdisciplinarios en biología —incluyendo la iniciativa DOE Genesis—, ciencias forenses, ciencias de la computación, matemáticas, neurociencia y aplicaciones de IA a la computación cuántica. Es Fellow de la American Physical Society y ha liderado importantes iniciativas de investigación, infraestructura computacional e inteligencia artificial que conectan ciencia fundamental, computación avanzada y descubrimiento basado en datos.

Dr. Manuel Montes y Gómez
Instituto Nacional de Astrofísica, Óptica y Electrónica (INAOE), Puebla, México.
Talk Abstract / Resumen
English
Depression is one of the most devastating mental health crises globally, with its main challenge lying in delayed diagnosis caused by social stigma and a lack of access to specialists. In this scenario, Natural Language Processing (NLP) and Artificial Intelligence emerge as key tools for early detection. By non-invasively analyzing social media content, algorithms can identify warning signs that are not always obvious to the naked eye, transforming massive unstructured data into predictive mental health variables.
This talk will present the methodologies and breakthroughs developed at the INAOE Language Technologies Laboratory to tackle this problem by identifying textual footprints left on social media. We will detail our shift from keyword analysis toward more complex representations that integrate emotional load, expressions of interest, and clinical symptom mapping, utilizing everything from traditional machine learning to state-of-the-art language models. Finally, we will discuss the technical challenges and ongoing projects at the lab, which focus on designing cutting-edge architectures under temporal, multimodal, and multilingual approaches.
Español
La depresión es una de las crisis de salud mental más devastadoras a nivel global, cuyo principal desafío radica en el diagnóstico tardío provocado por el estigma social y la falta de acceso a especialistas. Ante este panorama, el Procesamiento del Lenguaje Natural (PLN) y la Inteligencia Artificial surgen como herramientas clave para su detección. Al analizar de forma no invasiva el contenido publicado en redes sociales, los algoritmos pueden identificar señales de alerta no siempre evidentes a simple vista, transformando datos masivos no estructurados en variables predictivas de salud mental.
En esta charla se presentarán las metodologías y avances desarrollados en el Laboratorio de Tecnologías del Lenguaje del INAOE para abordar este problema a partir de la identificación de las huellas textuales plasmadas en las redes sociales. Se detallará cómo pasamos del análisis de palabras clave hacia representaciones más complejas que integran carga emocional, expresiones de interés y mapeo de síntomas clínicos, utilizando desde aprendizaje automático tradicional hasta modelos de lenguaje de última generación. Finalmente, se discutirán los retos técnicos y proyectos en curso del laboratorio, enfocados en el diseño de arquitecturas de vanguardia bajo enfoques temporales, multimodales y multilingües.
Biography / Reseña Curricular
English
Dr. Manuel Montes is a Senior Researcher in the Computer Science Department at the National Institute of Astrophysics, Optics and Electronics (INAOE). His research focuses primarily on information retrieval, text mining, and authorship analysis. He has published around 350 papers in international journals and conferences, which have earned him recognition as a National Researcher (Level II) by Mexico's National System of Researchers and Scientists (SNII), as well as a regular membership in the Mexican Academy of Sciences.
Dr. Montes has been a visiting professor at the Universitat Politècnica de València and the University of Alabama at Birmingham. He is also a founding member of both the Mexican Academy of Computing (AMEXCOMP) and the Mexican Association for Natural Language Processing (AMPLN). Within the framework of the AMPLN, he has organized several editions of the National Workshop on Language Technologies and the Mexican Workshop on Plagiarism Detection and Authorship Analysis, as well as the Autumn School on Language Technologies. Additionally, he has coordinated various evaluation shared tasks covering author profiling, aggressive language analysis, fake news detection, violent event reporting, and inappropriate meme identification at IberLEF, the premier evaluation forum for NLP systems in Spanish and other Ibero-American languages.
Español
El Dr. Manuel Montes es investigador en la Coordinación de Ciencias Computacionales del INAOE. Su trabajo de investigación se orienta principalmente a los temas de recuperación de información, minería de texto, y análisis de autoría, sobre los cuales ha publicado alrededor de 350 artículos en revistas y congresos internacionales, que le han valido el reconocimiento de Investigador Nacional nivel II del SNII, así como ser miembro regular de la Academia Mexicana de Ciencias.
El Dr. Montes ha sido profesor invitado en la Universidad Politécnica de Valencia, y en la Universidad de Alabama en Birmingham. También es miembro fundador de la Academia Mexicana de Computación y la Asociación Mexicana de Procesamiento de Lenguaje Natural. En el contexto de esta última ha sido organizador de varias ediciones del Taller Nacional de Tecnologías del Lenguaje, del Taller Mexicano sobre Detección de Plagio y Análisis de Autoría. de la Escuela de Otoño de Tecnologías del Lenguaje, así como de tareas de evaluación sobre perfilado de autores, análisis de lenguaje agresivo, detección de noticias falsas, reporte de hechos violentos, e identificación de memes inapropiados en el IberLEF, principal foro de evaluación de sistemas de procesamiento de lenguaje en español y otras lenguas iberoamericanas.
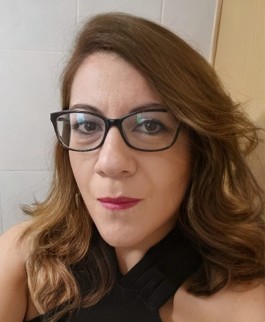
Dra. Maricela Claudia Bravo Contreras
México
Talk Abstract / Resumen
English
Description Logic (DL), the Semantic Web Rule Language (SWRL), SPARQL, and SHACL are often combined within the same ontology-based system, yet they are frequently treated as interchangeable tools for "adding logic" to a knowledge graph. In this talk, I will show that each formalism actually answers a fundamentally different question: DL asks what is necessarily true in every model of an ontology; SWRL asks what new fact should be derived when a given pattern holds; SPARQL asks which mappings match a graph pattern under a chosen entailment regime; and SHACL asks whether a dataset satisfies a set of structural constraints.
These differences are not merely stylistic but rest on distinct logical foundations — open-world versus closed-world semantics, decidable subsumption versus Horn-rule inference, and validation versus entailment — which give rise to recurring points of confusion in practice, from rules that cannot be rewritten as DL axioms without losing decidability, to OWL restrictions mistaken for data-quality constraints. Through a layered characterization of reasoning, rule inference, querying, and validation, illustrated with a running example spanning all four languages, this talk will explain where their boundaries genuinely overlap and where they do not, offering practical guidance for knowledge engineers on selecting the appropriate formalism for a given competency question rather than defaulting to a single tool for every task.
Español
La Lógica Descriptiva (DL), el Lenguaje de Reglas para la Web Semántica (SWRL), SPARQL y SHACL suelen combinarse en un mismo sistema basado en ontologías, pero con frecuencia se tratan como herramientas intercambiables para "añadir lógica" a un grafo de conocimiento. En esta plática explicaré que, en realidad, cada formalismo responde a una pregunta fundamentalmente distinta: DL pregunta qué es necesariamente cierto en todo modelo de una ontología; SWRL pregunta qué nuevo hecho debe derivarse cuando se cumple un patrón; SPARQL pregunta qué mapeos coinciden con un patrón de grafo bajo un régimen de entailment determinado; y SHACL pregunta si un conjunto de datos satisface un conjunto de restricciones estructurales.
Estas diferencias no son meramente estilísticas, sino que descansan en fundamentos lógicos distintos —semántica de mundo abierto frente a mundo cerrado, subsunción decidible frente a inferencia por reglas de Horn, y validación frente a entailment— que generan confusiones recurrentes en la práctica, desde reglas que no pueden reescribirse como axiomas DL sin perder decidibilidad, hasta restricciones OWL confundidas con restricciones de calidad de datos. Mediante una caracterización en capas del razonamiento, la inferencia por reglas, la consulta y la validación, ilustrada con un ejemplo transversal que recorre los cuatro lenguajes, en esta plática explicaré dónde sus fronteras realmente se superponen y dónde no, proporcionando orientación práctica para que los ingenieros de conocimiento seleccionen el formalismo adecuado según el tipo de pregunta de competencia, en lugar de recurrir por defecto a una sola herramienta para toda tarea.
Biography / Reseña Curricular
English
Dr. Maricela Claudia Bravo Contreras is a full-time Professor-Researcher in the Systems Department at Universidad Autónoma Metropolitana, Azcapotzalco (UAM-A), where she has worked since 2011. She holds a Ph.D. in Computer Science from CENIDET and has carried out research stays at the University of Oxford and Oxford Brookes University. She is a member of Mexico's National System of Researchers (Level 2), holds the PRODEP Desirable Profile, and received the UAM Teaching Award in 2021.
Her research focuses on ontology engineering, the Semantic Web, and knowledge graphs. She has worked on web service discovery and composition and on context-aware systems. More recently she has worked on ontology-based modeling of patient profiles and on building knowledge graphs from medical texts in Spanish. Her work has appeared in journals such as Journal of Biomedical Semantics, Applied Sciences, and Future Internet, and in book chapters published by Springer, IGI Global, and InTechOpen. She has supervised numerous master's and doctoral theses in Mexico and abroad.
Español
La Dra. Maricela Claudia Bravo Contreras es profesora-investigadora de tiempo completo del Departamento de Sistemas de la Universidad Autónoma Metropolitana, Unidad Azcapotzalco, desde 2011. Es Doctora en Ciencias de la Computación por el CENIDET y ha realizado estancias de investigación en la Universidad de Oxford y en Oxford Brookes. Es miembro del Sistema Nacional de Investigadores (nivel 2 a partir de enero de 2027), cuenta con el Perfil Deseable PRODEP y en 2021 recibió el Trigésimo Premio a la Docencia de la UAM.
Su investigación se centra en la ingeniería ontológica, la web semántica y los grafos de conocimiento. Ha trabajado en el descubrimiento y la composición de servicios web, en sistemas sensibles al contexto y, más recientemente, en el modelado ontológico de perfiles de pacientes y en la construcción de grafos de conocimiento a partir de textos médicos en español. Ha publicado en revistas como Journal of Biomedical Semantics, Applied Sciences y Future Internet, y en capítulos de libro de Springer, IGI Global e InTechOpen. Ha dirigido numerosas tesis de maestría y doctorado en diversas instituciones del país y del extranjero.
More keynote speakers and industry experts will be announced soon. Stay tuned!